

”Vår data duger inte.” Det är det vanligaste skälet till att inte börja, och nästan alltid handlar det om fel problem.
Oftast betyder det att kategorierna spretar. Tre personer klassar samma fel på tre olika sätt. Hälften av arbetsordrarna ligger under en allmän rubrik som ingen har brytt sig om att förfina. Begreppen gled isär när den senaste skiftledaren slutade. Om det är du som skulle behöva försvara datan, är det den bilden du har framför dig när du säger att den inte duger.
Den sortens röra går att leva med i dag. Något annat, som oftast får mindre uppmärksamhet, gör det inte. Att veta vilket som är vilket avgör om ett projekt kan starta eller inte.
Vad AI förlåter: struktur
Kravet som har försvunnit är kravet på struktur.
Det gamla arbetssättet krävde att alla användare kategoriserade allt rätt redan vid registreringen: rätt felklass, rätt komponent, rätt orsak, från en rullgardinslista, i slutet av ett skift. Leonard Lin, produktchef för Maintmaster Manufacturing Intelligence, är rak om hur bra det fungerade: ”ingen gör det, det är alldeles för mycket jobb.”
Obligatoriska kategorifält blir ifyllda. De blir inte rätt ifyllda. Man väljer det första alternativet som verkar rimligt, och klassificeringen du tog fram blir ett register över vad som stod överst i listan.
Just därför går det i dag att analysera data med svag struktur. Fritext går att läsa. Din klassificering behöver inte vara fullständig, konsekvent eller ens särskilt bra, eftersom analysen inte längre är beroende av den för att förstå vad som hänt.
Alltså: spretiga kategorier, begrepp som glider, en samlingskategori med alldeles för mycket i. Förlåtet.
Vad AI inte förlåter: det som saknas
Här går gränsen, och den handlar inte om ordning och reda. Det handlar om huruvida något alls skrevs ner.
Ta fyra avslutskommentarer för samma fel. Ungefär den spridningen hittar du i alla system som har varit i gång några år:
| Avslutskommentaren | Vad den ger dig |
|---|---|
| Ingenting. Inget visar att det här hände. | |
| ”Fixat.” | Något att räkna, inget mer. |
| ”Bytt lager.” | Vad som gjordes. Inte vad som var fel, alltså inte om det hjälpte. |
| Lager på drivsidan hade skurit, bytt och nysmort | Vad som var fel och vad som gjordes. Användbart. |
Bara den sista går att lära sig något av, och det krävdes åtta ord.
Den tredje är det intressanta fallet. Den ser ut som en riktig registrering och är den som lättast klarar en intern revision. Den säger att något gjordes. Den säger inte vilket problem åtgärden gällde. Därför kan den inte heller säga, ett halvår senare, om lagerbytet var rätt beslut eller om samma uppriktningsfel i tysthet äter upp ett lager per kvartal.
Vad de tomma kostar går att säga exakt. Leonard igen:
”Då vet man att problemen finns, men inte hur man löser dem, och då kan man inte lära sig av det.”
Lägg märke till vad som finns kvar och vad som inte gör det. Antalet finns kvar. Du ser fortfarande att maskinen har gått sönder elva gånger. Du kan fortfarande ta fram nyckeltalet för felfrekvens och lägga det på en dashboard. Det du inte kan är att lära dig: inte vad som var fel, inte vad som fungerade, inte om samma åtgärd har gjorts elva gånger på ett fel som ingen har diagnostiserat.
Det här är ändå en mycket bra utgångspunkt. En stor del av underhållshistoriken ser ut så här, och den ger dig redan överblick.
Händelserna finns i ett system och någon stänger jobben. Det är den dyra delen, och den är redan gjord. Med den här överblicken kan du börja föra förbättringsdiskussioner utifrån data. Du har data som motiverar varför du vill fokusera på ämne X. Nästa steg, ”skriv in åtgärden”, är ett logiskt steg som känns rimligt för teamet att ta. Arbetet med att förbättra datan kommer då i gång av sig självt.
Lägstanivån, och åt vilket håll den gäller
När det gäller kvaliteten på kommentarerna i datan är AI väldigt kapabel i dag, men det finns också en enkel lägstanivå. Det finns ett test för den som du kan göra på en eftermiddag, utan några verktyg. Leonards version:
”Om en människa inte förstår det, blir mjukvaran inte bättre på det.”
Läs ett urval av förra månadens avslutskommentarer. Kan du inte se vad som hände, kan inget annat det heller.
Leonard var noga med att i efterhand skriva ner var hans egen regel slutar gälla. Det är värt att säga exakt, eftersom det är den delen som missförstås. Regeln gäller bara åt ett håll. Om en människa inte kan läsa en anteckning har AI ingen chans med den. Men det finns fortfarande fall där en människa kan läsa en anteckning och AI inte kan det.
Att människor kan läsa det är alltså en lägstanivå, inte en garanti. Den visar säkert vad som är oanvändbart. Den intygar inte att allt ovanför fungerar. Att läsa regeln som våra anteckningar går att läsa, så vi klarar oss är att läsa den baklänges, och det skapar förväntningar som din data kanske inte lever upp till.
Leonards andra gräns är äldre och har inte flyttat sig: ”har man felaktigheter i sina rapporter blir det ingen bra analys.” Lägre krav på struktur är inte lägre krav på sanning. En registrering som säger fel sak är värre än en tunn. En tunn registrering syns, en felaktig gör det inte.
Var du faktiskt står
Den användbara frågan är inte om din data är bra, utan var den är dålig. Det går att svara på utan en revision.
Manufacturing Intelligence mäter hur stor andel av anteckningarna som håller användbar kvalitet och delar upp det per avdelning och per skift. Du får en karta i stället för en dom: vilka områden, vilka team, var registreringen tunnas ut. Då blir ett datakvalitetsprogram ett samtal med tre namngivna skiftledare.
En ärlig begränsning. Kartan visar var registreringen är svag. Om teamen sedan blir bättre när de har sett den har vi inte följt upp, så vi tänker inte presentera det som ett resultat. Kartan visar var du ska titta. Någon måste fortfarande gå dit och ändra hur registreringen görs.
När analysen arbetar med tunna registreringar säger systemet att det är osäkert. Det signalerar låg säkerhet i stället för att presentera ett tunt svar som ett säkert. Det är ingen garanti för att svaret är rätt.
Ingen har perfekt data
En invändning finns kvar efter allt det här, och det är den som oftast sägs högt: vi har inte perfekt data.
Det har ingen, och Leonard är tydlig med varför:
”Ingen har perfekt data, för ingen har någonsin använt den. Så klart att den inte är bra.”
Det är ett påstående om orsak och verkan, och det går åt motsatt håll mot hur problemet brukar beskrivas. Registreringar blir inte bra först och används sedan. De används, och det är det som får någon att skriva dem ordentligt. Data som ingen någonsin har läst är data som ingen någonsin har haft skäl att förbättra.
Därför kan du börja med halvbra data. Säg att 50 % av dina avslutskommentarer innehåller både problemet och lösningen. Eller säg att alla nämner problemet och ingen anger lösningen. Ingen av dem skulle någon kalla bra, och i båda finns de viktiga frågorna ändå med i urvalet och syns. De viktiga frågorna är nämligen de som återkommer, och det som återkommer hamnar i ett urval av den storleken. Det som kommer ut är användbart och visar riktningen: det pekar ut rätt maskiner och rätt återkommande fel utan att mäta dem exakt. Det är vad du behöver när beslutet framför dig är var du ska titta först.
Det förändrar också hur registreringen blir bättre. Ett team som ser att dess anteckningar används har ett skäl att skriva dem. Ett team som lägger anteckningar i ett system som ingen läser har det inte. Om det faktiskt blir så har vi, som sagt, inte följt upp. Det är ett argument för att börja tidigt, inte ett resultat vi kan visa dig.
Börja alltså använda datan när du är halvvägs, och låt Manufacturing Intelligence lyfta registreringen därifrån i stället för att vänta på att allt ska vara rätt först.
De tre frågorna
Ställ dem om ett urval av dina egna avslutade arbetsordrar, i den här ordningen:
- Finns det någon registrering alls? Ingen registrering är inget datakvalitetsproblem. Det är ett problem med att data saknas, och det är ett annat projekt.
- Kan en människa se vad som hände och vad som gjordes? Om inte, blir inget längre fram bättre. Det här är lägstanivån.
- Stämmer det som står? Värt en titt, men sällan där ett team kör fast.
Det här är inget resultat från en undersökning, och vi tänker inte klä ut det till ett. Det är vad vi hör i demosamtal: team kommer i tron att de har ett problem med fråga tre, och det de sedan beskriver är fråga ett. Inte en felaktig registrering, utan ingen alls: papper, ett kalkylark, en skiftbok, ett samtal vid skiftbytet.
Det här gör du först
Varje fråga pekar på ett eget första steg, och inget av dem är en städning du måste bli klar med innan du börjar.
Fråga ett faller: få in händelsen i ett system. Inte ett bättre system, utan ett system. Leonard sätter ribban för första steget medvetet lågt: det ”behöver inte vara vårt”. Det viktiga är att händelsen fångas när den inträffar och inte rekonstrueras i efterhand. För underhållet är det ett underhållssystem i stället för ett kalkylark. För linjestopp är det produktionsräknare som fångar händelserna automatiskt i stället för en skiftbok som skrivs i slutet av dagen. Inget av det är ett AI-projekt. Båda är det som gör ett sådant möjligt.
Fråga två faller: ändra vanan, inte strukturen. Här gör kartan över anteckningarnas kvalitet nytta. Du ber tre skiftledare om två korta fraser i stället för ett ord. Du behöver inte göra om klassificeringen.
Fråga tre faller: prova och se var du står. Det behöver du inte reda ut innan du börjar. Manufacturing Intelligence ger dig vägledning om var de svaga punkterna finns.
Det är värt att säga vilken ordning det här vänder på. De flesta organisationer kommer till allt detta från analyshållet. Någon vill ha en dashboard eller en prognos, och datan dyker upp som ett hinder på vägen. Leonard skiljer mellan ”någon som vill analysera datan och att digitalisera sin data. Analysera kan man göra sen.” Det är två projekt, och de blandas ihop hela tiden.
Om du redan har följt viktiga nyckeltal för underhåll ett tag har du ett försprång när du ska skilja de tre åt. Nyckeltalet ger dig antalet, och frågorna visar om det finns något bakom det.
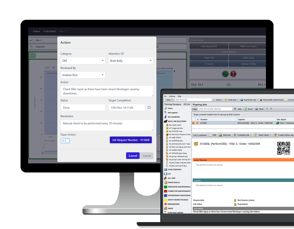
Ta fram tjugo avslutskommentarer och läs dem. Den andel som faller på fråga två är din verkliga utgångspunkt, och den har du nu utan att ha köpt något. Om de flesta faller behöver du inget dataprogram. Du behöver en plats där man skriver två korta fraser direkt där jobbet görs, och det är vad Maintmaster CMMS är till för.